新卒入社して6年ちょっと働いた会社を退職しました
2025年8月22日に、新卒の頃から在籍していた会社を退職しました。
2019年4月に新卒として入社して、6年と4ヶ月ほど在籍していました。
次の会社は決まっており、現在は約2ヶ月の有休消化中です。
本日最終出社でした
— ishikawa_pro⛳️ (@ishikawa__pro) 2025年8月22日
6年間お世話になりました!!
10月中旬まで夏休みです pic.twitter.com/P33fndgTJw
退職理由としては、特に会社が嫌になったとかではなく、自身のスキルアップとキャリアアップのためです。
どんなことをやってきたかを多分どんどん忘れていくので、新卒からこれまでどんなことをやってきたか、ざっくり振り返りも書いておこうと思います。
極めて個人的な振り返りなので、最後まで読んでも得られるものはありません。
2019〜2021年8月
最初の半年は、結構古いサービスのバックエンドのちょっとした機能追加やリファクタリングとかをやっていました。
社内で Node.js を使い始めた頃に書かれたサーバーで、非同期処理が callback や Promise やco + generator など、色々入り乱れていて Node.js の歴史を感じながら開発していました。
半年が過ぎると、仮配属から本配属になり、自分は全然違うチームに異動となりました。
異動先では、新規サービスの立ち上げとかをやるチームに移動しました。
新規サービスの立ち上げと言っても、普通にゼロから作るのではなく、社内でマイクロサービスとして構築された headless CMS や認証・決済基盤などを利用して、新規サービスを開発するというのが、そのチームのミッションでした。
当時は、マイクロサービス側もできたばかりで、チームも新しくできたばかりという状態だったため、前例もほぼなく全て模索しながら開発するというような感じでした。
さらに、これからは TypeScript を採用していくという方針になったため、社内で詳しい人もいない中でTypeScript を学びながら、前例のない社内の共通基盤を利用しながら新規サービスを開発するということをやっていました。
最初は本当に大変でしたが、みんなで模索しつつ徐々に前例を作りながら開発パターンのようなものも出来始めていきました。
このような新規サービスの構築とか、大きめな機能追加のプロジェクトとかを2年半くらい点々とやっていました。
2021年9月
前述した社内のサービス開発基盤を使いながら新しいサービスや機能を開発するというやり方も、かなりパターンができてきました。一方で個人的には、毎回同じようなことばかりやっているなと感じるようになってきました。
また、当時 ISUCON にも1人で参加しており、前年と比べても良い結果ではなかったことから、技術的な伸び悩みを感じてきていました。
そこで転職を考えていたのですが、特にリファラルとかをしてもらえるようなエンジニアの知人もいなかったため、軽い気持ちで X にポストしてみました。
転職したいと思ってるんですが、人脈が無くて困ってます。
— ishikawa_pro⛳️ (@ishikawa__pro) 2021年9月2日
Twitterさん助けてください。
新卒3年目サーバーサイドエンジニア
Node.js, TypeScript歴2年
自社プラットフォームを開発・活用しながら、新規事業の立ち上げに沢山携わってました
マイクロサービスの設計とか好きです
希望年収550万〜
すると、なぜかプチバズってしまい、すぐに人事との面談が入りましたw (今でも昔 X でバズってましたよねってたまに声をかけられます)
面談では、上述しているようなことを人事とマネージャーに話して、もっとパフォーマンス改善や開発基盤の改善など、技術力を上げられるような仕事がしたいと言ったところ、チーム異動させてもらうことになりました。
異動後(2021年10月)
異動先は、数名のシニアエンジニアで構成されているチームで、開発基盤のパフォーマンス改善や社内の開発ツールキットのメンテナンスをしたり、場合によってはサービス開発に入って色々なサポートをしたりする、今で言う Enabling とか Platform Engineering と言われるチームに異動しました。
異動後は、これまでの経験を活かして、サービス開発チームの設計をレビューしたり、基盤側のメンテナーとしてコードレビューをしたり、パフォーマンス改善をしたり、たまにサービス開発に入ってサポートしたりしていました。
あとは、2年目くらいから DevOps にも興味が出始めて、k8s の本や分散システムなどのインフラ寄りの勉強もするようになりました。インフラがちょっと分かってくると、 CI/CD や k8s のマニフェストなども自分で書いたりするようになり、自然と SRE との関わりが増えるようになりました。
当時は、CI/CD や環境構築も含めて、インフラ面はほぼ SRE に丸投げする文化だったのが、ここ数年はバックエンドエンジニアが自分でやるようになったので、少しは DevOps に貢献できたんじゃないかなと思っています。
当時読んで影響を受けた本


2022年
異動して数ヶ月した2022年2月ごろに、新卒の頃からお世話になっていた先輩社員が転職しました。
backend のリードエンジニアで、自分以外の人も頼りまくっていたので、個人的には大きな出来事でした。
先輩とは同じチームで働いていたこともあり、自分もいくつか引き継ぎをしたのですが、コードレビューの量が圧倒的に多くなって、最初の頃はどうやってレビューを捌きながら自分の仕事をやったらいいのか結構悩んでいました。
今振り返ると、当時は自分の「こうあるべき」というこだわりが強すぎていたなと思います。(コードの書き方とか設計とか)
そういう過度なこだわりは、一つ一つに細かく目を通しすぎてしまい、時間がいくらあっても足りないし、ゲートキーパーとしてみんなの障壁になってしまいます。
そして、自分の時間の足りなさや、ゲートキーパーとしてみんなの仕事の速度を落としてしまう申し訳無さなどから、あまり細かいところまでは見すぎないように意識するようになっていきました。
これは、単にレビューが雑になったということではなく、守るべき部分がどこなのか、どういうトレードオフ(デッドラインや既存システムとのしがらみなど)があってそういう設計になっているのか、などを加味して、どういう落とし所にするか考えるようになっていきました。
そういう開発や運用体制のあり方については、「システム運用アンチパターン」という本にすごく影響を受けました。
www.oreilly.co.jp
この年の自分の取り組みとしては、フロントエンドが Next.js を採用するにあたり、サーバーのホスティング場所をどうするかなどについて設計を進めていました。結果として、 Cloud Run を中心としたホスティング基盤を設計したり、 Cloud Run の revision 機能を活用した Preview Deploy 機能を構築しました。
このあたりを機に、k8s や Cloud なども積極的に触ったり、SRE と一緒に設計したりするようになりました。そして DevOps 方面に興味が向き始めていたんだろうなと思います。
cam-inc.co.jp developers.cyberagent.co.jp
あとは、Tilt というOSSのツールを使って、 local k8s cluster でローカル開発環境が構築できるように刷新 & 移行したりしていました。
この移行も、アプリケーション開発者と k8s の距離をいかに縮められるかなどを意識して、設計を詰めて取り組みました。
特に影響を受けた Lyft の記事。
eng.lyft.com
この年は、そういった取り組みなどを評価していただき、半期に1度開催される社内のアワードでベストエンジニア賞を頂きました。
2023年
2023年は Platform Engineering との出会いの年でした。
当時、自分は backend エンジニアという職種だったのですが、backend のコードはあまり書いていないので若干違和感を感じていました。かといってサイト信頼性に責任を持つわけでもなかったので SRE でもないなと思っており、これは世の中的にはどういう仕事なんだろうと色々調べていたら Platform Engineering という言葉にたどり着きました。(当時、日本でも話題になり始めてたのもあり)
Platform Engineering という言葉を知ったときは、まさに自分がやっていることや、やりたいことはこれだなと感じました。
そして、自分の気持ち的に Platform Engineering が盛り上がっているタイミングで、 Platform Engineering Meetup の運営メンバーを募集しているのをたまたま見かけて、面識もない jacopen さんのツイートに飛び込んでいきました。
Platform Engineering Meetup、第2回以降一緒に運営やっていただける方を募集します!
— Kazuto Kusama(jacopen)☄ (@jacopen) 2023年2月20日
1人だと開催が不定期になったり、イベントの方向性が偏ったりという可能性があるため、複数人で運営することで安定して良いイベントをできるようにしたいと思っています。
手伝って頂ける方はコメントください!
このおかげで、勉強会や Community の Slack などを通して Platform Engineering のトレンドを追えるようになりました。
仕事の方では、自分が入社してすぐにローンチされたサービスで、自分も色々開発に関わっていた思い出深いサービスが終了しました。サービスが終了しても、その裏側で動いているマイクロサービス群は内部プラットフォームとして生き続けているのですが、深く関わったサービスだったので感慨深いものがありました。
あとは、エンジニアの各職種のリーダーが集まって、半期に1回の頻度で技術組織の半年先や1~3年先の職種毎のロードマップを考えたりする合宿が、開催されるようになりました。
当時、ぼくはまだ合宿に参加する立場ではなかったのですが、 backend エンジニアとして事前に色々話し合って議論したり準備したりするのに加えてもらっていました。
この頃は、エンジニア組織としても数年がかりの大きなプロジェクトがひと段落し、この先どうしていきたいか?などのビジョンや方向性などを考える必要がありました。
当時の自分は、細かい技術的な問題など、目先の課題などについてしか考えることがありませんでした。そのため、もっと俯瞰的に考えたり、 backend 組織としてどういう課題に向き合っていくか、などについて考えるいい機会になりました。
この年の合宿で、 Polyrepo + Microservices という構成をやめて、 Monorepo + Modular Monolith に移行していくという決定もしました。
技術的な詳細は、会社の技術ブログでも解説しています。
当時読んで影響を受けた本


2024年
2024年は Platform Engineering に関する活動をたくさんしました。
仕事以外での活動でいうと、2月に Platform Engineering Meetup 運営メンバーとして Developers Summit に登壇させていただきました。
次に、こちらも Platform Engineering Meetup 運営メンバーとして、 CodeZine にて記事を書きました。
運営メンバーでの連載だったのですが、自分は Internal Developer Platform について解説しました。
こういったメディアへの寄稿は初めてで、一度はやってみたいなと思っていたので、実現できてとても嬉しかったです。
codezine.jp
次に、 Platform Engineering Kaigi 2024 の実行委員をやりました。
やったこととしては、公式サイト開発チームのリーダとして、3名のチームでサイト構築をしました。
当時はまだ ClaudeCode などの優秀なコーディングエージェントもない時代だったので、得意でもないフロントエンドを頑張ってオーガニックコーディングで、セッション募集開始の前日の深夜まで開発したのもいい思い出です。
あとは、実行委員だけでなく、会社がカンファレンスのスポンサーをやっていた関係で、スポンサーブースの企画を考えたり、スポンサーセッションとして登壇もしました。
カンファレンス規模のイベントに一人で登壇するのはこれが初めてだったので、緊張しましたが、これもとても貴重な経験になりました。
登壇系だと、AEON TECH HUB というAEONさんが主催してるイベントで、「大規模システムの効率的運用の裏側」というテーマでパネルディスカッションをしたりしました。
ぼくはアドリブが苦手なので、事前にもらったトークテーマをもとに、めちゃくちゃ準備して同僚にもチェックしてもらったりしてから挑みました笑
aeon.connpass.com
仕事面でも Platform Engineering に関する活動をたくさんしました。
2023年末か2024年の始めくらいに、 CTO からそろそろ Platform Engineering にも注力していきたいという話があり、3~4名くらいの規模で全員別業務と兼務で Platform Engineering のチームができました。
仕事内容的には今までとそこまで変わってない気がしますが、 Platform Engineering っぽいこととしては、ドキュメント整備などを頑張ってみたり試験的に Backstage を導入したりしました。あとは頻繁に社内で勉強会を開いたりして、社内でも Platform Engineering の勉強会とか、 Platform Engineering Team の取り組みとかを発信したりしていました。
2025年
2025年は、CTO が別の事業部へ異動するという大きな変化から始まりました。色々な面でお世話になっていたので、最初に聞いた時は本当にびっくりしました。
その影響もあってエンジニアの組織編成も色々と変わり、自分はエンジニアボードというエンジニアの各職種のリーダー1~2名程度で構成されるグループのメンバーに加わりました。(このグループで半期に1回の合宿に行ったり、毎週の定例で情報共有などをやっています)
あとは、エンジニア向けのAIツールの導入にかなり注力しました。
2025年の初めの方では、Claude 3.7 や o3 や Devin の登場など、コーディングエージェントの性能が大幅に上がり、世間ではとても盛り上がっていました。
一方で社内では GitHub Copilot によるコード補完くらいしか活用できておらず、他のツールなども検証してみたいけどどうしようか、という感じで誰もリードせずに止まっていました。
そこで、エンジニアボードという立場も利用して、自分が旗振りをしてAIエージェント系ツールの比較や検証などを進めていくようになりました。
結果として、 Devin と Cursor を会社として導入して、エンジニアが使えるように社内用のドキュメントやルールなどを整備しました。
この辺の意思決定を、今までだと CTO に頼っていたりしたのですが、自分の意思を持ってリードして進めることができたのも、個人的には成長を感じました。(もちろん周りのサポートがあってのことですが。)
Devin はかなり会社にフィットして活用できていたので、 Devin Meetup Tokyo というイベントでその辺りの発表もしました。
自分が退職する直前には、かなりのエンジニアが Cursor を利用しており、Slack の Devin チャンネルでは色々なエンジニアが Devin に指示を出すようになっており、それなりに達成感がありました。
まとめ
こうして振り返ってみると、徐々にステップアップして行っている様が見えるのと、いいタイミングで貴重な機会を与えてくれた周りの人たちに感謝しかないなと思います。
6年でたくさんの経験を積ませていただいた会社や職場の人たちに感謝をしながら、次の職場でも頑張ろうと思います。
LLM時代のパフォーマンスチューニング:MongoDB運用で試したコンテキスト活用の工夫
このエントリは「第35回 中国地方DB勉強会 in 岡山」で「LLM時代のパフォーマンスチューニング:MongoDB運用で試したコンテキスト活用の工夫」というテーマで登壇した内容をブログ化したものです。発表スライドと発表時の文字起こしをベースに、読み物として違和感のないように整え直しました。図版はスライドのものを流用しています。
背景と目的
- AIコーディングエージェントを“機能開発”だけでなく“性能改善”にも活用した実践記を共有します。
- コードだけでは見えない現実(スロークエリやアクセス分布)を「コンテキスト」として渡し、提案→実装→再測定のループで改善幅を可視化します。
- 今回の事例は MongoDB + Node/Express + Mongoose のミニECですが、RDB環境でも同じ発想を応用できます。
題材アプリの概要
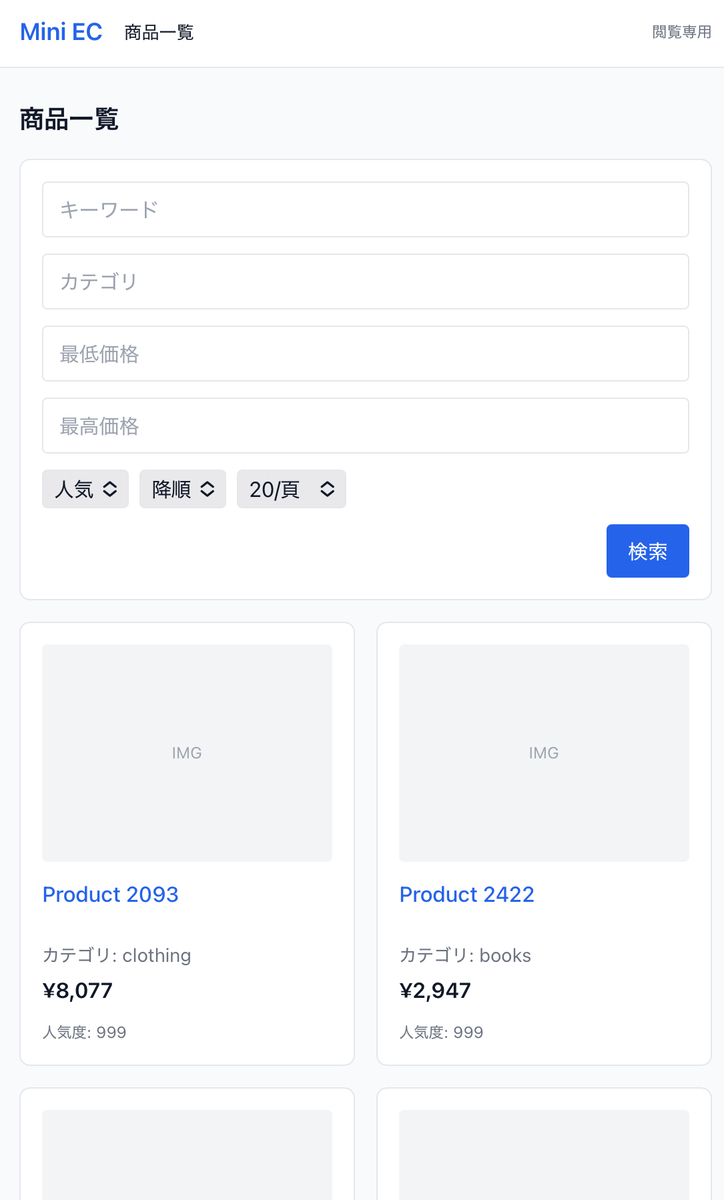
- サーバーは Node.js + Express、ODM は Mongoose、データベースは Docker 上の MongoDB を利用しています。
- フロントは商品一覧と詳細のみを持つ簡易構成で、本記事ではバックエンド寄りの視点に集中します。
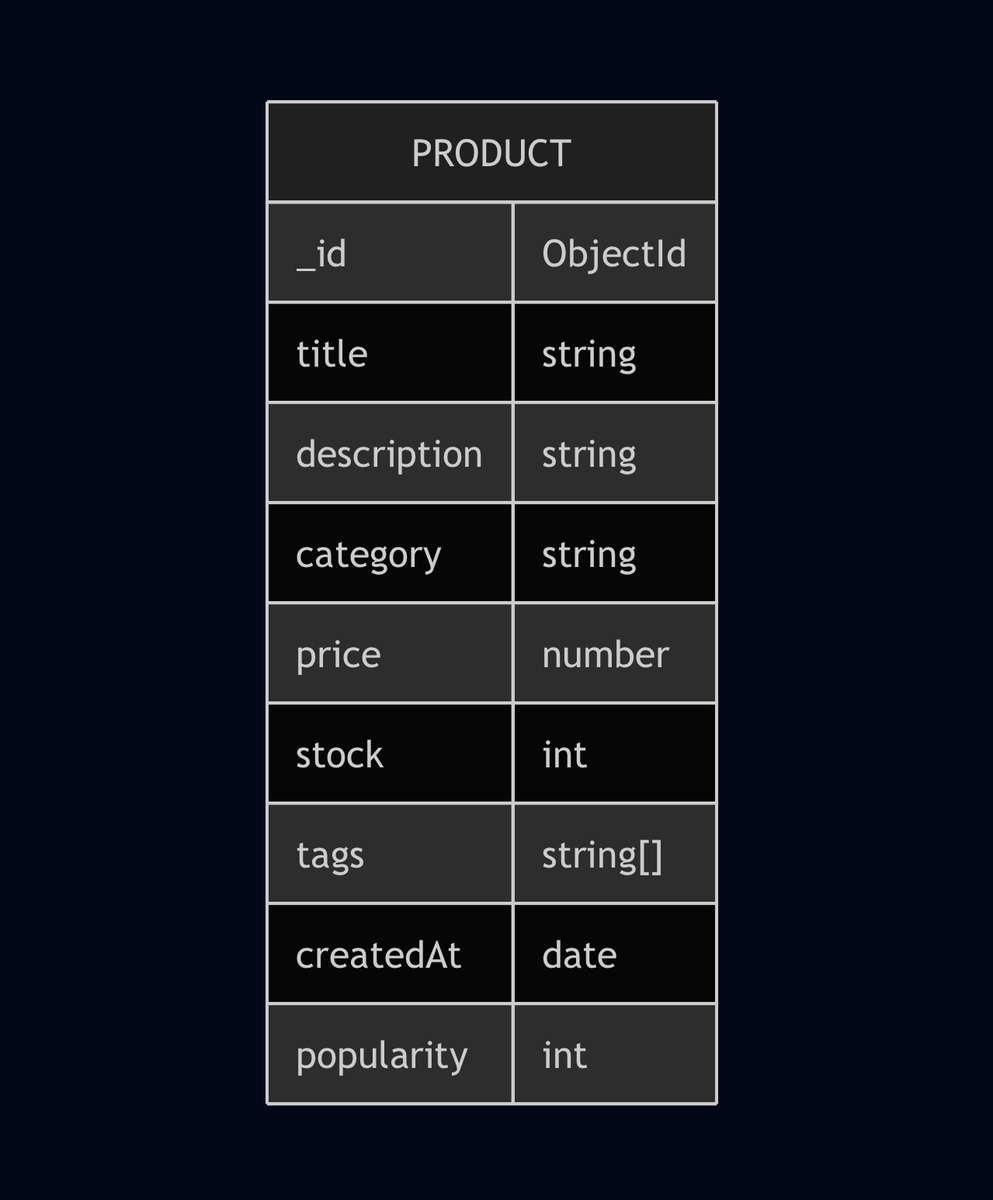
- プロダクトスキーマの主要フィールドは
title, description, category, price, stock, tags, createdAt, popularityです。

パフォーマンス計測設計
- データは 10 万件のサンプルを事前に投入してから計測
- 負荷は k6 の
ramping-vusを用い、同時接続 5→25 を 3 分でランプさせたあと 2 分維持し、30 秒でクールダウンさせる - リクエスト配分は一覧が 7 割、詳細が 3 割で、ソートは popularity 40%、price 30%、createdAt 30% に振り分ける。昇順と降順は半々、ページは 1〜5、件数は 12/24/48 をランダムに選択し、適宜 keyword や category、min/maxPrice を付与
- 計測対象は API レイテンシ(平均値、95 パーセンタイル)と、100ms 以上の MongoDB スロークエリ
k6シナリオは以下のような設定です(抜粋)。
export const options = {
  scenarios: {
    baseline: {
      executor: 'ramping-vus', startVUs: 5,
      stages: [ { duration: '3m', target: 25 }, { duration: '2m', target: 25 } ],
      gracefulRampDown: '30s',
    },
  },
  thresholds: {
    'http_req_duration{endpoint:GET /products}': ['p(95)<500'],
    'http_req_duration{endpoint:GET /products/:id}': ['p(95)<300'],
  },
};
// 7:3で一覧と詳細を叩き、ソート・ページ・条件を都度ランダム化
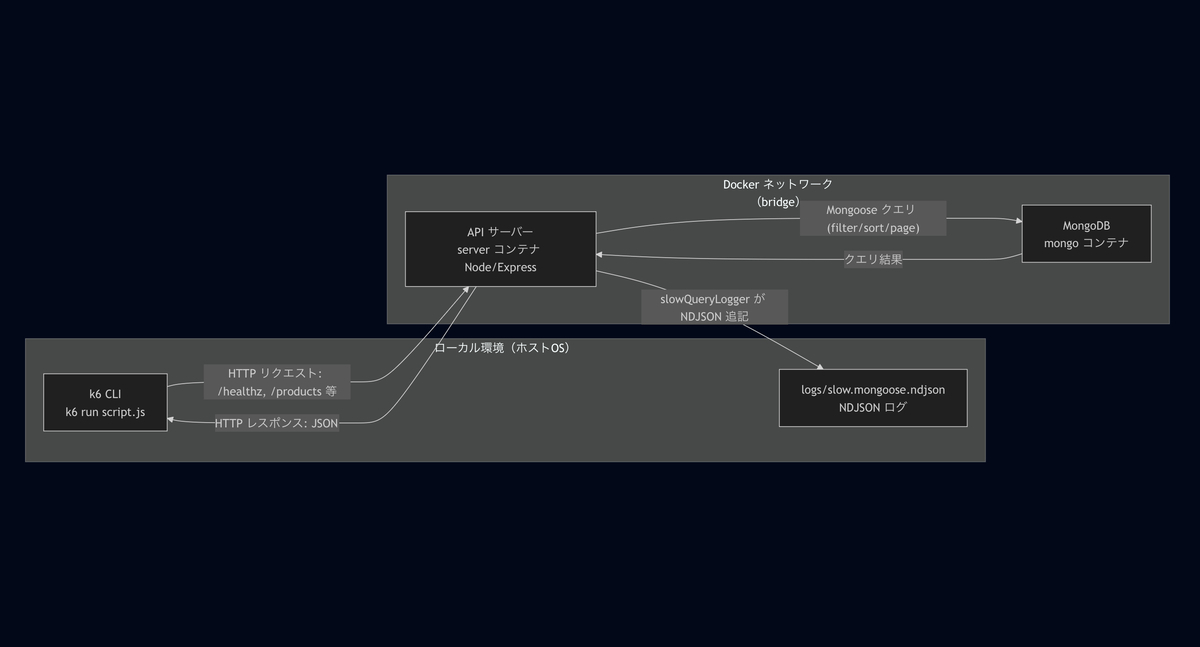
下記は負荷試験のアーキテクチャ図です。
改善前の状況(ベースライン)
/productsの平均は 57.90ms、p95 は 149ms(n=16,150)/products/:idの平均は 5.85ms、p95 は 35ms(n=6,951)- スロークエリは
findとcountDocumentsが中心で、p95 はそれぞれ 194ms と 179ms

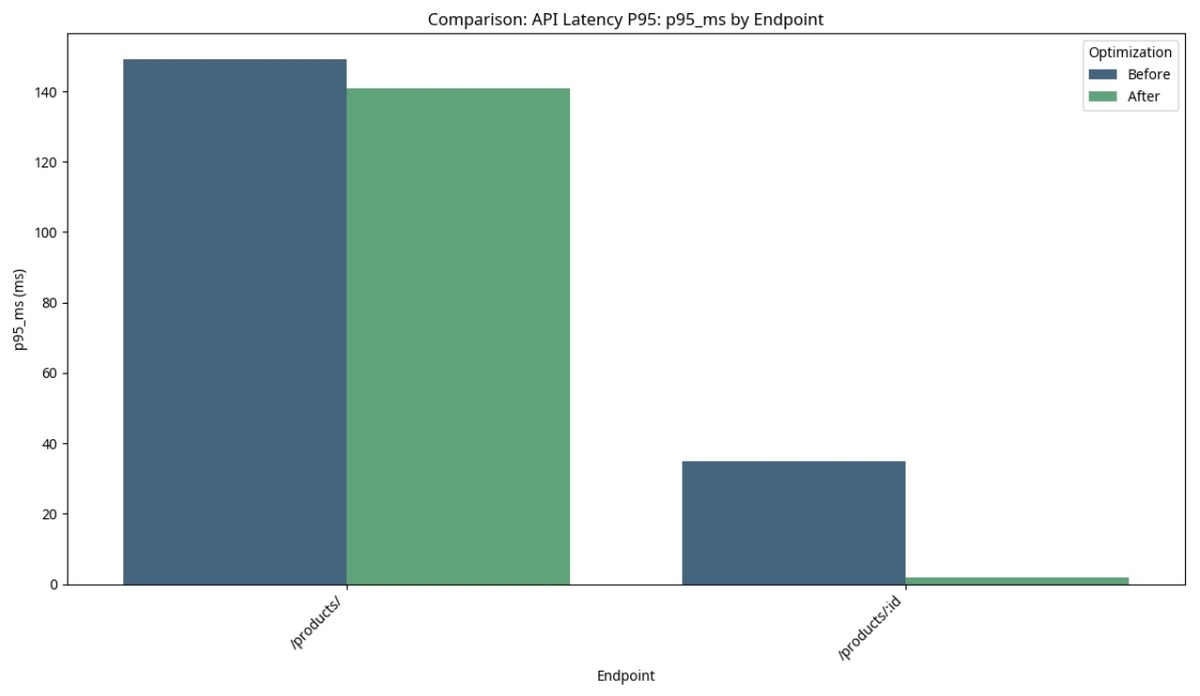
API の p95 レイテンシーは次の図のとおりです。

MongoDB のスロークエリ散布図は以下のとおりです。
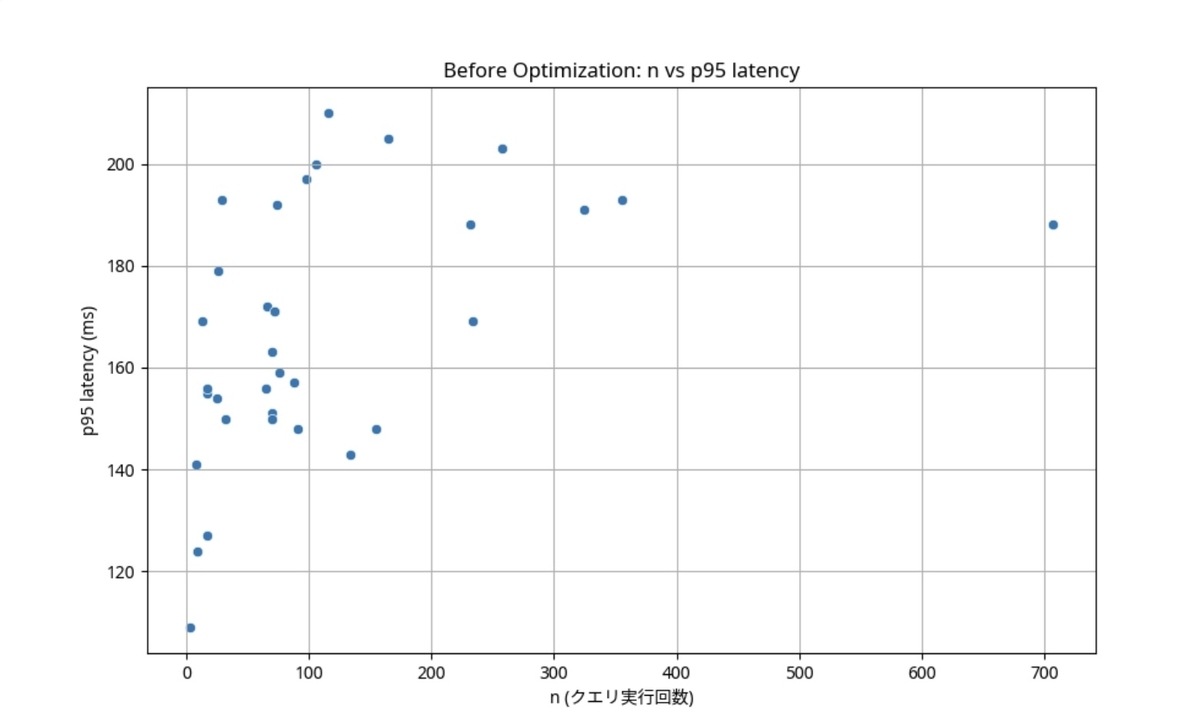
スロークエリログの収集と集計フロー
- サーバー側では Mongoose の自作プラグイン(slowQueryLogger)を挿入し、100ms を超えたクエリを NDJSON に 1 行追記するようにしました。
- サンプル(整形した slow query log)は次のとおりです。
{
  "ts": "2025-09-12T15:48:45.906Z",
  "layer": "mongoose",
  "op": "countDocuments",
  "model": "Product",
  "collection": "products",
  "ms": 100,
  "filter": { "$or": [ { "title": {} }, { "description": {} } ] },
  "options": {}
}
Slow Query Log をリポジトリに commit して、Codex で slow query log を集計させました。

jq で数値を ? に正規化し、(op, model, filter, options) 単位でグルーピングして件数と p95 を CSV に出力しました。
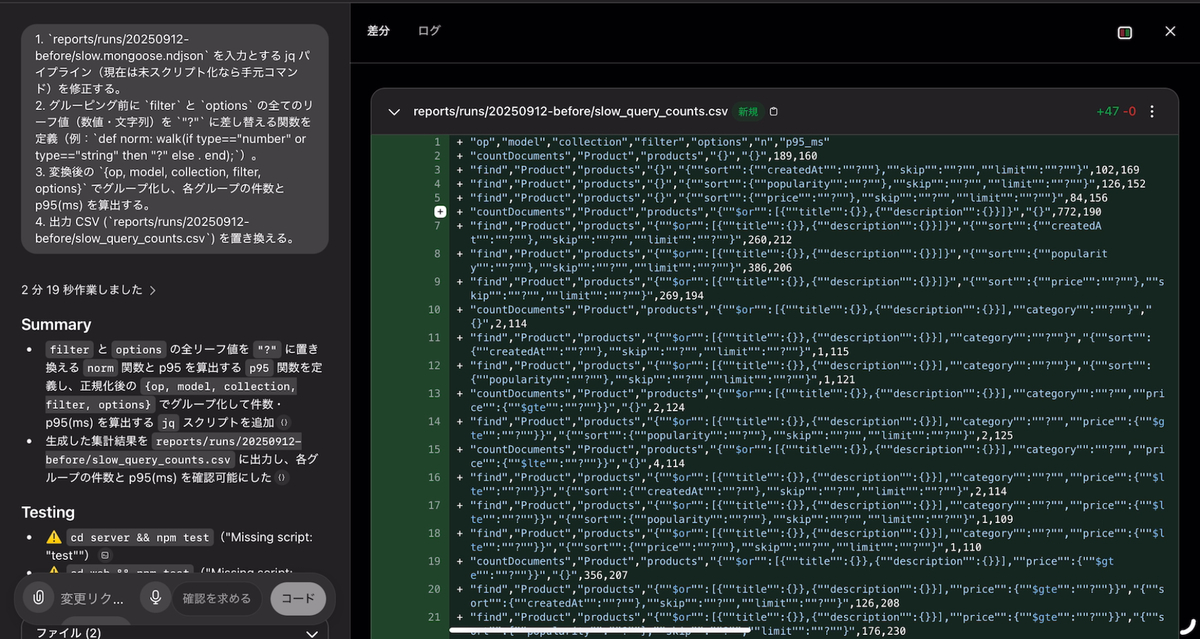
集計CSV(抜粋):
"op","model","collection","filter","options","n","p95_ms"
"countDocuments","Product","products","{}","{}",134,143
"find","Product","products","{}","{""sort"":{""createdAt"":""?""},""skip"":""?"",""limit"":""?""}",70,151
"find","Product","products","{}","{""sort"":{""popularity"":""?""},""skip"":""?"",""limit"":""?""}",91,148
"find","Product","products","{}","{""sort"":{""price"":""?""},""skip"":""?"",""limit"":""?""}",70,150
"countDocuments","Product","products","{""$or"":[{""title"":{}},{""description"":{}}]}","{}",707,188
"find","Product","products","{""$or"":[{""title"":{}},{""description"":{}}]}","{""sort"":{""popularity"":""?""},""skip"":""?"",""limit"":""?""}",355,193
エージェントへのコンテキストと提案
Codexにはコードベースと集計した CSV をコンテキストとして渡しました。
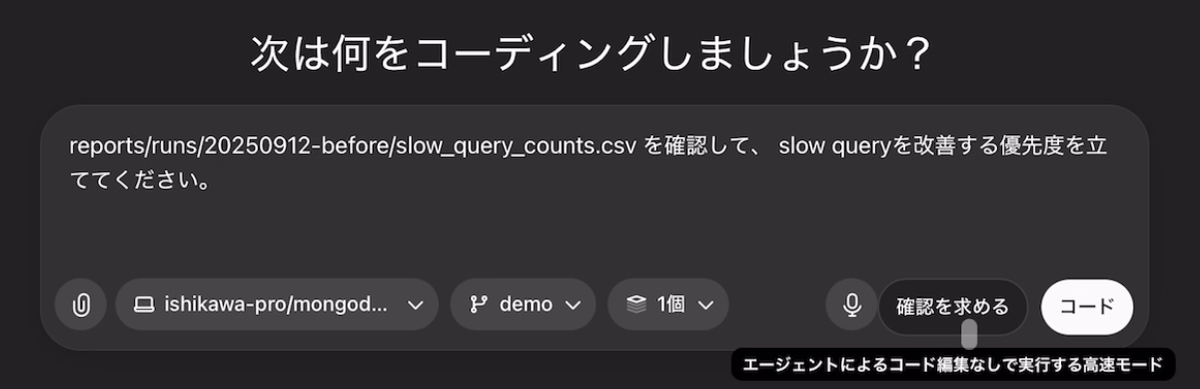
下記のように提案してきました。

提案の核:
title + descriptionのテキストインデックスを追加popularityとcreatedAtに単一インデックスを追加price+popularityとprice+createdatの複合インデックスを追加- こちらはそのまま採用せず、まずは単一インデックスで効果を確認する。
下記は分析結果をもとに Codex が提案してきた推奨タスクです。
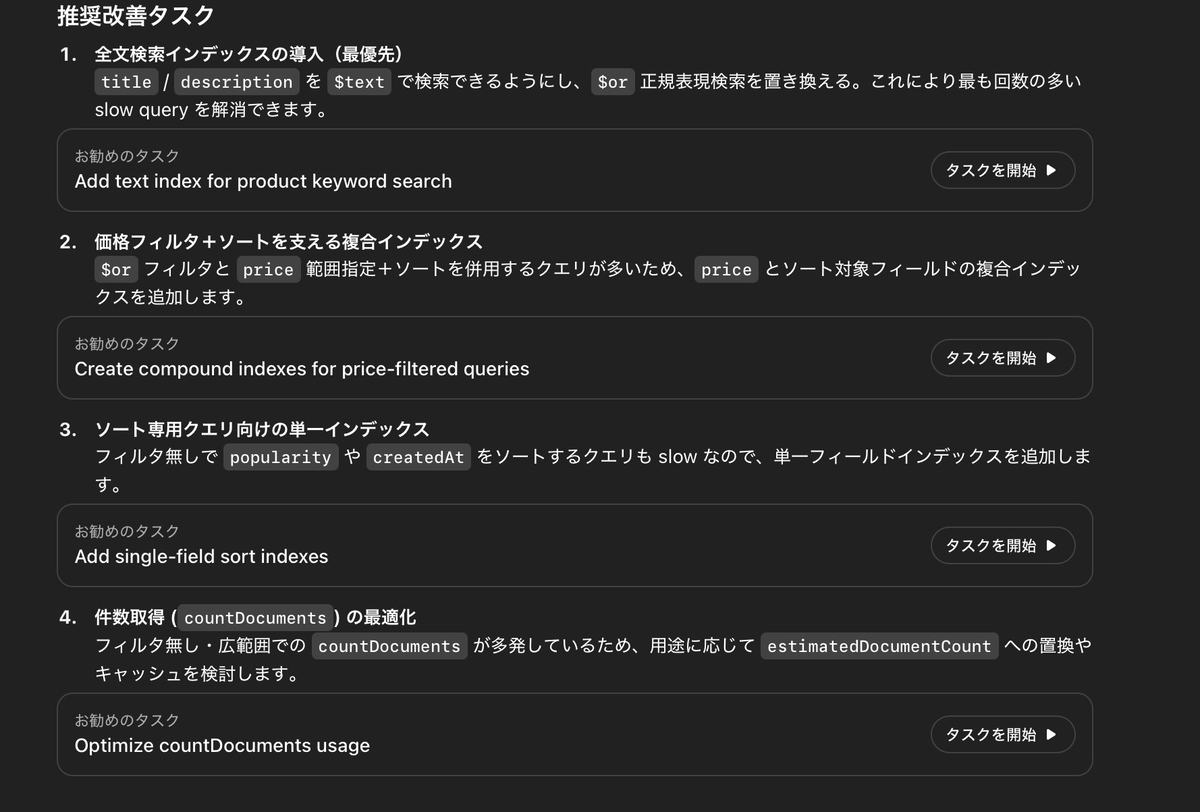
実装ダイジェスト
テキストインデックス(title, description)の追加
Codex のタスク画面は次のとおりです。

実際に作成した Pull Request のスクリーンショットです。
正規表現での検索から全文検索への query 修正もやってくれています。

単一インデックス(popularity, createdAt, price)の追加
こちらも Codex のタスク画面です。

対応する Pull Request のスクリーンショットです。

追加後のインデックス一覧(_id, category 以外で 4 つ追加)です。

再計測の結果
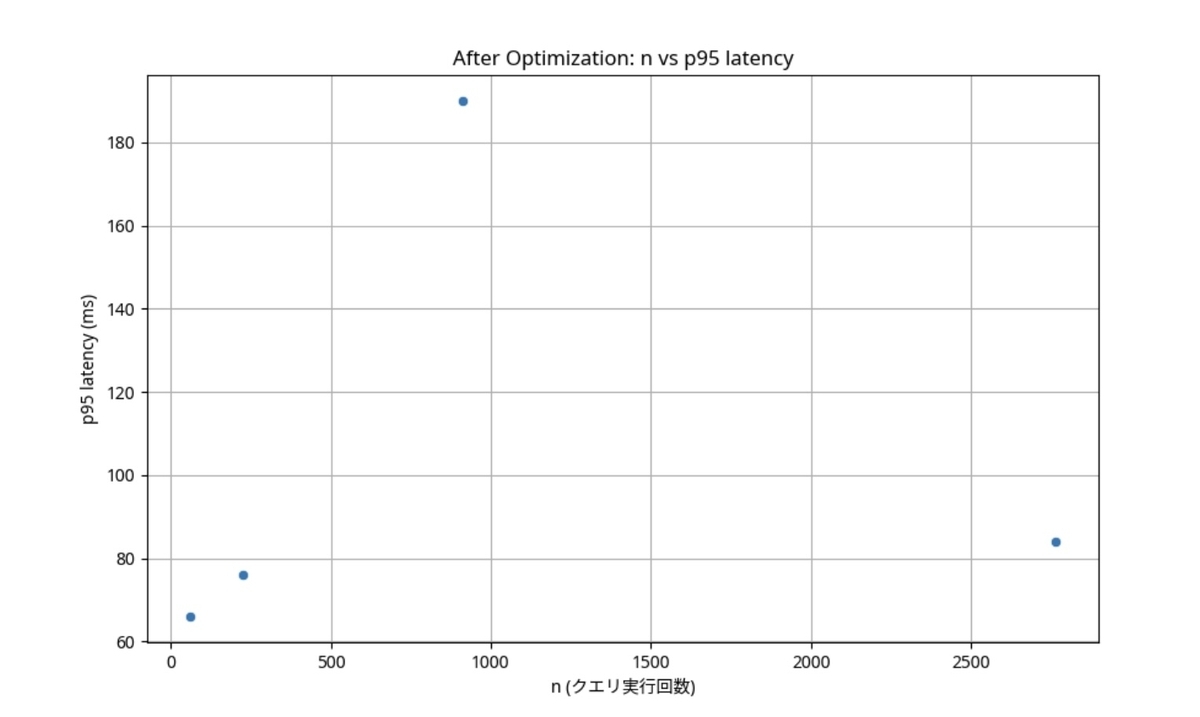
/productsの平均は 29.05ms、p95 は 141ms(n=17,812)/products/:idの平均は 0.896ms、p95 は 2ms(n=7,454)
API平均
一覧取得の平均が約半減しており、ソート軸(popularity / createdAt)の単一インデックスで走査が軽くなった影響が大きいです。

API p95
詳細取得は p95 が 35ms → 2ms と顕著に改善しており、find のスロークエリが消えたことが寄与しています。
一覧の p95 が伸び切らない要因は countDocuments で、ページングのためのカウントがボトルネック化していると考えられます。
slow query
MongoDB のスロークエリは find がほぼ消失し、countDocuments が残存しています。
まとめ
- コード外の情報(slow query やアクセスログなど)を渡すと、性能改善の精度が一気に上がります。
- ログはリポジトリにコミットする必要はなく、都度適切な形で共有・要約できれば十分に活用できます。
- 実務では Observability ツールや計測基盤から得た指標を組み合わせることで、ボトルネックの特定と検証をさらに効率化できると思います。
- 値はマスキングしても問題ありません。どんなクエリ項目の組み合わせでリクエストされるかという構造だけでも有用なコンテキストになります。
- 提案は鵜呑みにせず、変更は小さく入れてメトリクスと再測定で自分の目で確認・検証し、効果が曖昧ならロールバックも検討しましょう。
新婚旅行を支えたChatGPT──パリ・ロンドン実録レポート
こんにちは。6月9日〜19日にかけて、新婚旅行でパリとロンドン(1日だけ)を訪れました。
旅行中にかなり色々な場面で ChatGPT を活用したので、折角なのでその記録を残しておきます。
ちなみに妻は海外旅行の経験が何度かありましたが、ぼく自身は高校の修学旅行で台湾に行って以来の海外旅行でした。海外初心者のぼくにとって、不安も多い中、どう ChatGPT を使ったのかをお楽しみください。
Manus で下調べをしたのも記事にまとめているので良かったらこちらもご覧ください。 ishikawa-pro.hatenablog.com
航空券・フライト関連
今回のフライトは、成田→ドバイ と ドバイ→パリ という乗り継ぎで行きました。飛行機の乗り継ぎ自体経験したことがないので不安しかなかったのですが、ChatGPT に予約情報を渡して、何度も問題ないか確認したりしました。


また、帰りは パリ→ドバイ, ドバイ→羽田 というフライトで帰る予定で、乗り継ぎ時間が1時間しかありませんでした。パリ→ドバイがディレイしたら詰むねと妻と話していましたが、案の定ディレイして乗り継ぎに失敗してしまいました笑
しかしこの時も、ぼくは不安だったのであらかじめ ChatGPT に乗り継ぎに失敗したらどうしたらいいか確認しており、航空会社が次の便の手配と待ち時間が長い場合はホテルも手配してくれるということを教えてもらっていました。本当に乗り継ぎが失敗した時はちょっと焦りましたが、航空会社がなんとかしてくれると分かっていたので、心の余裕は保ったまま手続きなどをしてもらいました。

ドバイ→羽田行きの飛行機は1日1本しか出てないらしく、翌日の便に乗るしかなくなったため、便の予約とホテルを手配してもらいました。僕は疲れてホテルでダラダラ過ごしていましたが、妻は ブルジュ・ハリファ やショッピングモールで半日ドバイを満喫していたので、結果オーライという感じで良かったです。
余談ですが、ドバイの空港は広すぎて10mおきくらいに道を聞いてホテル行きのバス停まで行ったのですが、ドバイの人たちはとても親切な方ばかりで、とても丁寧に道を教えてくれたり、かなり遠くまで一緒に歩いて案内してくれる人もいました。
市内交通
パリの交通機関であるメトロやバスの利用方法について、ChatGPTに詳細に教えてもらったおかげで、実際の移動が非常にスムーズでした。特にバスの乗り方については、どこから乗り込むのか、運賃はどう支払うのかなど、事前に知らなければバス停で戸惑うことになりがちです。しかし、ChatGPTに聞いておいたことで非常にスムーズに利用できました。


観光計画
観光計画では、妻が行ってみたい場所をGoogle Mapsでまとめていたので、それをスクショでChatGPTに渡して、地理的に近い場所をグルーピングしてもらい、スケジュールの提案などをしてもらいました。
o3 に google maps でピン付きのマップ画像を渡す

行きたいところをリスト化してもらう

リストを地理的に近いエリアでグルーピングしてもらう

グルーピングした情報を元に、観光の計画案を立てる

提案された通りに観光することはなかったですが、予定を組む上でとても参考になり、充実した観光ができました。
宿泊施設の対応
Airbnbホストとのメッセージのやり取りは ChatGPT に考えてもらったりしました。

Airbnb の部屋では使い方が分からないものがいっぱいあったので、ChatGPT に色々聞きまくりました。
タオルウォーマーについて

換気扇の使い方について
 スライドして起動する機構なんて知らなかったので、本当にその通りに動いた時はちょっと関心しました。
洗濯機の使い方について
メニューがフランス語で書いてあり、みただけではさっぱりわかりませんでした。


洗濯機のトラブル(泡漏れ)が発生した際にも、対応方法を即座にアドバイスしてもらえました。

 無事に自体が収まったので良かったです。
言語サポート
フランス語は「ボンジュール」と「メルシー」だけで乗り切りました笑。パリの人は大体英語を話してくれたので、基本は英語でコミュニケーションしました。
英語に関しては2人とも得意ではないので、話したいことをChatGPTでシンプルな英語にしてもらい、それを元に英語で話すという感じで使いました。たまにGoogle翻訳も使ってみましたが、ChatGPTの方がメモリや会話履歴から文脈を意識してくれたり、自分たちが英語が苦手なことを考慮して、簡単な言い回しで教えてくれたりするので、ほとんどChatGPTを使いました。

ただGoogle翻訳のカメラで撮ったものを翻訳してくれる機能は結構使いました。フランス語で書かれたカフェのメニューなどを翻訳した文字で置き換えてくれるのは、とても便利でした。
翻訳内容はめちゃくちゃだが、実際の画像内の文字を置き換えてくれるので、どこに何が書いてあるか対比させながら見るのに便利。

異文化理解
街の人たちを観察して気になったことなどをChatGPTに聞いて理解を深める場面も多くありました。例えば、パリではカフェや公園でゆっくりしている人が多かったので、その背景にある文化的な考え方やライフスタイルについて質問し、詳しく知ることができました。
平日でもカフェでゆっくりしてる人が結構いて気になったので聞いてみた時

結構暑いのになんでエアコンないんだろうと疑問に思ったので聞いてみた時

異文化の中で「なぜこうなんだろう?」と思ったことをすぐに聞いて理解を深められるのは、AI時代だからこそできる贅沢な体験だったと感じます。
まとめ
今回の旅行では、ChatGPTがまるで旅のパーソナルアシスタントのように働いてくれました。情報検索だけでなく、実際に直面したトラブル対応や細かな翻訳、さらには異文化への理解まで、AIを活用することで、海外旅行の不安を大幅に軽減でき、とても充実した新婚旅行になりました。
海外旅行という非日常では、さまざまな場面で不明点や疑問が出てきます。そのような状況下で ChatGPT などの AI がいると、大抵のことは解決することができました。日本で生活しているだけだと、交通機関や家電の使い方など、普通に暮らす上で必要となることで、分からないことはあまりないし、国内のことなら検索の勝手もわかっているので、簡単に情報にアクセスすることができます。しかし、外国で且つプライマリーの言語が英語ではない国では、そういう情報にアクセスすることが非常に難しいです。
短い期間ですが、そういう状況に飛び込んだ経験と、それらを AI を使って解決していく経験はとても貴重な経験になりました。そして、日本に住む外国の方は、日々本当に大変な思いをしながら生活しているんだろうなと、少し共感することができました。
今後、旅行を計画している方は、ぜひAIを活用してみてください。きっと旅の快適さと楽しさが格段に向上するはずです。
AI ツールで質の高いアウトプットを得るために意識していること
今日は、ChatGPTなどの AI を使う時に、意識していることをまとめようと思います。
AI を使いこなしている人からすれば当たり前の話が多いかもしれないですが、最近は仕事で社内に AI 系ツールの導入をすることもあり、そこまでガンガン使ってない人でもよりうまく活用してもらうために、基本的なノウハウを改めて整理しておこうかなと思っています。
会話は適度に「まとめて切る」
まず最初に意識していることは、会話は適度に「まとめて切る」ことです。 ChatGPTなどのLLMとやり取りしていると、会話が長くなるにつれて、応答の精度が落ちてきたように感じることがあります。 内容が曖昧になったり、最初に話していた前提がずれてきたり……といったことが起こるのは、一見するとモデルの性能に原因があるようにも思えますが、実際は 会話の長さ=コンテキストの肥大化 が影響していることが多いです。
ぼくはこの問題を避けるために、会話を適度なタイミングで要約し、次のチャットとして区切るという方法を取るようにしています。 たとえば、あるテーマについて一通り話し終えたら、その時点で内容を整理しておきます。そして、そのまとめを新しい会話の冒頭に貼って、次のステップへと進めていきます。
こうすることで、モデルに渡す文脈がスリムになり、余計な情報に引っ張られずに、今フォーカスしたい内容に集中してもらえるようになります。
会話が長くなると精度が落ちてくる理由
会話は適度に「まとめて切る」ことを意識するうえで、AIがどのようにレスポンスを生成しているのか、その仕組みを理解しておくことが大切です。
Transformer モデルの内部構造まで詳しく知る必要はありませんが、どのようなAPIでやり取りが行われているのかといった基本的な動作原理は、押さえておくべきだと思います。
たとえば、OpenAIの Chat Completions API では、モデルが過去の会話を自動的に記憶しているわけではなく、毎回「messages」という形式で過去の履歴をすべてクライアント側から送信する必要があります。
つまり、会話が長くなればなるほど、APIに送るデータ量が増え、それがそのままモデルの処理対象になります。
以下は、その仕組みを示すcurlの例です。
curl -X POST https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-3.5-turbo",
    "messages": [
      {"role": "system",    "content": "あなたは親切なアシスタントです。"},
      {"role": "user",      "content": "こんにちは"},
      {"role": "assistant", "content": "こんにちは!どのようにお手伝いできますか?"},
      {"role": "user",      "content": "おすすめのラーメン屋を教えて"}
    ]
  }'
このように、APIではこれまでのやり取りをすべてmessagesとして構造化して送ります。 それぞれのメッセージにはroleという属性があり、これはその発言が「誰によるものか」を示します:
- "system":モデルの振る舞いや前提を指定するシステムメッセージ
- "user":ユーザーからの入力
- "assistant":AI(モデル)からの応答
会話が続くたびにこのmessages配列が長くなっていき、やがてモデルの処理限界(トークン上限)に近づいていきます。
また、古い文脈が新しい話題に影響を与えてしまうことで、応答の焦点がずれてしまうといった現象も起こります。
このような仕組みのため、必要な文脈だけを切り出し、次の会話に引き継ぐという整理がとても重要になってくるのです。
これは OpenAI の API に限らず、 Anthropic などの他の AI ツールでも同様です。
AIツール全般においてもコンテキスト長を意識する
ここまで紹介してきた、会話は適度に「まとめて切る」といった工夫は、ChatGPTのようなテキストベースのツールに限った話ではありません。
DevinやClineのような、開発支援や操作代行を行うAIツールでも、同じ考え方が通用します。
こうしたツールも、裏側では大規模言語モデル(LLM)とAPI経由でやり取りをしており、ユーザーからの命令や指示は、文脈(コンテキスト)として蓄積されながら処理されています。
つまり、セッションが長くなったり、やり取りが複雑になったりすると、モデルが処理する文脈も膨らみ、期待した通りの応答が返りにくくなる という課題は避けられません。
そのため、これらのツールでは 「うまくいかない」 と感じたときに、同じセッション上で試行錯誤を重ねるのではなく、 一度プロンプトを整理・改善して、ゼロからやり直す方が有効なケースが多い です。
複雑な作業ほど、ステップに分けて進める
次にぼくが意識していることは、やらせたい作業をいきなり一気に頼むのではなく、いくつかのステップに分けて段階的に進めるということです。
その際に大事なのが、最終的にどういう成果物を作りたいのかをざっくりでもイメージしておくことです。
ゴールを頭の中で思い描いておくと、そこにたどり着くまでに必要な要素や順序が見えてくるので、自然と「まずは〇〇を決めて、その次に△△を考える」といった進め方がしやすくなります。
たとえば次のような流れです:
最初に大枠や方向性を決める
- 「どういう構成で進めるか?」などをAIに相談する
個々の要素を1つずつ深掘りする
- 各パートや手順について、対話を通じて整理していく
最後に全体をまとめて仕上げる
- 各ステップで得られた内容を統合して、完成させる
こうしてステップごとに切り分けてやり取りを進めることで、AIとのやり取りが明確になり、意図に沿った出力を得やすくなると感じています。 結果として、自分自身の考えも整理され、作業全体がスムーズに進みやすくなる効果もあります。
重要なポイントはObsidianに抜き出して保存
AIとやり取りを重ねていると、「あれ、さっきのいいアイディア、どこで出てきたんだっけ?」と、必要な情報を見失いがちになることがあります。
特にチャット形式のツールでは、やり取りが流れていくため、会話の中に埋もれた重要な情報をあとから見返すのが意外と大変です。
ぼくはそれを防ぐために、ステップ分けした作業の各段階や、やり取りの中で出てきた大事なポイントを都度Obsidianに抜き出して整理するようにしています。
たとえば、AIと相談して出てきた構成案や、途中で得られた洞察、具体的な手順などは、そのまま貼り付けたり要約して記録しておきます。
このようにまとめておくことで、次のようなメリットがあります:
- チャット内で情報を探し回らずに済む
- 別セッションでAIとやり取りを再開する際、コンテキストを簡単に共有できる
- 複数ステップにまたがるタスクでも、情報が断片化せずに管理できる
Obsidianのようなノートツールを活用することで、チャットの断片的な情報を自分なりに整理された知識として残しておけるので、AIとのやり取りを一時的なものにせず、継続的な成果につなげやすくなると感じています。
まとめ
ChatGPTをはじめとする大規模言語モデル(LLM)を活用する場面が増えてくる中で、ただ使うだけでなく、どう使うかがますます重要になってきていると感じています。
この記事では、ぼく自身がLLMを活用するうえで日頃意識しているポイントを紹介してきました。
- 会話が長くなりすぎる前に内容を整理し、新しいセッションに切り替える
- モデルの仕組み(API)を理解し、文脈の持たせ方を工夫する
- 複雑な作業は、最終的なゴールを見据えたうえでステップに分割して進める
- 重要な情報はObsidianに抜き出し、流れない形で整理・再活用できるようにしておく
これらは一つひとつは地味な工夫ですが、積み重ねることでAIから引き出せるアウトプットの質が大きく変わってくると思います。
AIとの対話は、単なる「質問と答え」のやり取りではなく、思考や作業を支えるパートナーとの共同作業に近いものです。
だからこそ、そのやり取りをいかに設計するかが成果を左右する鍵になります。
今後もツールやモデルが進化していく中で、こうした基本的な使い方の工夫は、むしろより重要になっていくのではないかと思っています。
この記事が、これからAIツールをより深く活用していきたい人のヒントになればうれしいです。
旅行の下調べにAIを使った話:Manusでパリのレストランを調べた
こんにちは。
今日は AI サービスネタです。
6月にフランスへの新婚旅行を予定しています。パリを中心に滞在する予定で、レストランや観光地などを事前に調べる必要があります。
せっかくなら AI エージェントを使ってみようと思い、中国のスタートアップが開発したAIエージェント「Manus」を使ってみることにしました。
Manusとは
Manusは、Butterfly Effect AI(Monica)が開発した自律型AIエージェント。ユーザーの曖昧な指示をもとに、複雑なタスクを計画・実行する機能を持っている。複数のLLM(大規模言語モデル)を組み合わせて動作し、最終的な出力は整形されたウェブサイト形式で公開したりできる。
エンジニアの人なら、汎用型の Devin だと思って貰えばわかりやすいかもしれないです。
現在は招待制で、誰かから招待してもらうか、公式サイトから申請して招待を待つ必要があります。
ぼくは、別の用途で Manus を使ってみたかったので、公式サイトから申請したらすぐに招待がきました。
レストランの一覧を作成
Manusには、まずはパリでのディナー候補をリストアップしてもらいました。
以下の情報を渡した:
- 予算
- 苦手な食材
その結果、15分ほどで以下のような一覧ページが生成されました。
下記のような感じで、進捗や結果を報告してれます。

下記は実際に作成されたウェブサイトです。

下記の情報を8店舗分画像付きでまとめてくれました。
- シェフ
- 特徴
- 予算目安
- 苦手食材注意点
- 雰囲気
- ドレスコード
このページを妻に LINE で送って、みて貰えばよかったので、体験としてはよかったです。
各レストランの詳細調査
さらに気になったレストランについては、個別で調査しました。
Manus はタスクごとにクレジットを消費していくので、調査までやらせるとクレジットがもったいないです。
なので次は ChatGPT で調査をして、結果を Manus に渡して WebSite として公開するという流れでやりました。
下記がその例です。


この程度の作業であれば、15分ほどでデプロイまで完了しました。 事前に調査した内容を渡してホストするだけであれば、画像収集とコーディングとデプロイ作業だけなので、 200 クレジットくらいで済みました。
所感
出力結果がウェブサイト形式で共有できるため、他の人との相談や記録にも使いやすかったです。
また、フランスのレストラン公式サイトは英語対応されている場合もあるが、実際にはメニューなどがフランス語のままで、内容がわからないことが多かったです。そのため、ChatGPTやManusに日本語で要約してもらえるのは非常に便利だった。
さらに、妻に画像付きで見やすい形式の情報を共有したいとき、LINEではテキスト中心になってしまい、Notionに転記するのも手間がかかります。Manusで生成されたページはURLを送るだけで済むので、その点でも使い勝手がよかったです。ただし、誰でも閲覧できる形式でホストされるため、プライベートな情報は記載しないよう注意が必要です。
作業自体は本当に自律的にやってくれて、作業が終わったりユーザーからの指示が必要な場合は Push 通知で知らせてくれるので便利です。
ChatGPT などの他のAIサービスを契約している場合、調査などのタスクは ChatGPT でやって、 WebSite として公開するようなタスクを Manus にやらせるという分業をさせた方が、クレジットを節約できていいかなと個人的には思いました。
まとめ
今回は Manus を使って、旅行に関する情報を収集・整理してみました。
中国企業ということもあり、仕事には使えないですが、こういう使い方ではとても便利ですね。
NotebookLM をはじめ、情報の収集・整理の質や速度が劇的に変化しているなとよく感じます。
タチコマみたいなAIエージェントの完成も近い気がしますね。
招待コードが余っているので、知り合いの方で使ってみたい方がおられたら招待するので連絡ください。
ご飯を考える負担を減らしたくて、Nosh を始めてみた
今日は、テック系の話ではなく私生活の効率化的な話で、数ヶ月前から導入している Nosh(ナッシュ) という冷凍ミールをデリバリーしてくれるサービスについて紹介&振り返ってみようと思います。
背景など
我が家は子なしの共働き夫婦で、平日は2人とも 10:00 ~ 19:00 で仕事があります。食事の準備は、基本的に夫婦のどちらか余裕がある方が担当してきましたが、手が回らない日はスーパーやコンビニのお弁当、市販の冷凍食品などで済ませることも少なくありませんでした。
また、ホットクックや食洗機などの家電も活用し、調理や片付けの自動化には積極的に取り組んできました。
それでも、忙しい日の夕食準備は負担に感じることがあり、「今日はどうするか」を考える時間や気力が残ってないこともあります。あわせて、夕食準備にかかる労力を減らすことで、夫婦それぞれの可処分時間を少しでも確保したいという思いもありました。
在宅勤務の日もありますが、出社した日は帰宅後に食事を用意する余裕がないことも多く、「夕飯どうするか」の会話自体がちょっとしたストレスになることもあります。ぼくはコンビニ弁当でも特に問題はないのですが、妻は食事のバランスを重視するタイプで、自炊が難しい日でも栄養面が気になるようでした。
こうした状況から、料理ができないときの選択肢をあらかじめ用意し、判断の手間を減らす目的で、冷凍の宅配弁当サービスを導入することを検討しました。
いくつか検討した結果、nosh(ナッシュ) を使ってみることにしました。
nosh に決めた理由
他にも選択肢はありましたが、nosh に決めた理由は以下の通りです。
電子レンジで温めるだけで食べられる手軽さ
メニューの種類が豊富で、定期的に新しいメニューが追加されるため飽きにくい
継続利用によって割引が進む「nosh club」制度がある
主食(ご飯)は付属していないが、我が家では日常的に多めに炊いたご飯を冷凍保存しており、準備の手間が少なく相性が良かった
初回は10食セットを注文
初回は10食セットを注文し、現在は毎週のペースで継続利用しています。
noshでは自分でメニューを選択できるため、夫婦で5食ずつ好きなメニューを選びました。
届いた商品は冷凍庫に収まりやすく、温め時間もパッケージに記載されています。食べたいときにすぐ使える利便性は高いと感じました。
食べてみた感想
味に関しては、冷凍とは思えないクオリティで、とても満足度が高かったです。野菜も一定量含まれており、満足度は高かったです。
妻の反応も良好で、継続利用に前向きな感触を得られました。
利用しているタイミング
現時点では、以下のタイミングで活用することが多いです。
- 火・木のリモートワーク日のお昼ごはん
- 月・水・金の出社日の夜ごはん
- 疲れて食事の準備が難しい日の夕食
冷凍なので保存がきき、必要なときにすぐ使える安心感があります。
また、「何を食べるか考える時間」が減ったことで、全体的な生活の負担が軽減されました。
気になった点(デメリット)
全体的には満足度が高いサービスですが、いくつか気になる点もありました。
- 苦手な食材があると選択肢が減ることがある(妻は豆類が苦手で、副菜に豆が使われていることが多いため、若干メニュー選びの幅が狭まっている)
- メニューの選択を毎週忘れると前週と同じものが届く(実際に3週連続で忘れたことがあったが、意外と飽きなかった)
- 冷凍庫の容量を多く使う(10食分はなかなかのボリュームで、ふるさと納税の返礼品と被ったときは冷凍庫がパンク寸前になった)
まとめ
nosh を導入してみて実感したのは、食事の準備には思った以上にエネルギーを使っていたということです。
忙しい日々の中で、適度に生活の手間を減らせる選択肢があると、精神的な余裕が生まれやすくなります。
現在は10食セットを毎週のペースで運用しています。自炊や外食と組み合わせながら、無理なく活用できており、当面はこのスタイルで継続していく予定です。
もしこの記事を読んで nosh に興味を持った方がいれば、以下の招待リンクから登録すると5000円分の割引が受けられる(ぼくも3000円分の割引が得られる)ので、よければ使ってみてください。
Ollama を試すためのModelに関する知識と選び方
こんにちは。
今日は、ぼくが Ollama で Local LLM をいろいろ試し始めた時に必要だった、LLM の Model に関する知識について整理しておきます。誰かが Local LLM を試してみたい時に、どの Model を使ったら良いのかの参考になれば幸いです。
Ollama で使える Model
まずは Ollama が扱える Model についてです。Ollama では GGUF という形式の、 Model を扱うためのファイルを利用します。GGUF はバイナリファイルで、モデルの重みや、さまざまなメタデータや、量子化に関する情報を持っています。
基本的には、 Ollama の公式ページに公開されている GGUF 形式の Model を Pull して利用することになります。
あるいは、 Hugging Face で誰かが公開した GGUF 形式の Model も利用することができます。
Hugging Face に公開されている GGUF の Model は、下記のようにすることで利用することができます。
ollama run hf.co/{ユーザー名}/{リポジトリ名}
LLM 界隈だと Hugging Face で Model を公開されることが多いと思いますが、それら全てが Ollama で試せるわけではなく、 GGUF 形式のもののみ利用することができます。つまり、話題の DeepSeek-R1 がオープンモデルだからといって Hugging Face から落として簡単に試せるというわけではなく、GGUF 形式にされたものを探してくる必要があります。
ちなみに話題の Model は大体 GGUF 形式のものが公開されています。
Model 選びのための前提知識
次に Model の選び方について説明したいのですが、その前に必要となる前提知識について説明しておきます。ぼくは機械学習エンジニアではないのと、そこまでしっかり勉強したわけではないので、間違っている部分があったらすいません。
パラメーター数
まずはパラメーター数についてです。ChatGPT などの LLM を使っている人なら分かっていると思いますが、パラメーター数は多いほど頭がいいです。しかし、パラメーター数が多ければ多いほど、必要な VRAM (GPU のメモリ) も多くなります。Ollama の場合は、VRAM に乗り切らない時は、RAM にスワップしたりしてどうにか Model を実行しようとしてくれますが、非常に低速になるので実用的ではありません。
したがって、Local LLM では自分が利用している VRAM のサイズを理解し、VRAM に乗り切るサイズの Model を使うことが重要です。
量子化
パラメータ数について理解した後に必要になってくるのが量子化です。 LLaMA などの LLM は通常、何十〜何百億のパラメータ数があるため、そのまま動かそうと思うと VRAM が数十GB以上必要になります。そのようなグラフィックボードを持っている人はいいですが、大抵の人は数GBのVRAMが乗ったグラフィックボードしか持っていないはずです。そこで量子化の登場です。
量子化とは、機械学習モデルの計算精度(数値のビット数)を減らして、メモリ使用量を削減し、計算速度を向上させる手法です。普通のニューラルネットワークは32ビット浮動小数点を利用しますが、量子化ではモデルの数値表現を 整数(INT8, INT4 など) に変換します。そうすることでメモリ使用量を削減し、計算速度を向上させることができます。
また、Model を FP16(半精度浮動小数点) に変換して数値精度の削減がされたモデルもあります。 FP16 は量子化とは違い、整数化せずに計算精度を落とします。なぜ FP16 にするといいのかというと、最近のGPUには FP16 の計算に特化したコアが別途搭載されており、 FP16 で計算することでVRAMの使用量を削減しつつ、比較的高精度な計算を高速にすることができるからです。
NVIDIA の GPU をお持ちの場合、RTX 20 シリーズ以降は Tensor Core というFP16で最大4×4要素の行列同士を積和算できるプロセッサが搭載されています。 Tensor Core が乗っている場合は、FP16 のモデルを利用すると比較的高い精度で高速に推論することができると思います。
残念ながらぼくの GPU は、 RTX シリーズが出る前の GTX 1660 Super なので、 Tensor Core は搭載されておらず、これらの性能差は試せていません。
【余談】
なぜコンシューマー向けのグラボに機械学習向けの Tensor Core を搭載しているのかについては、backspace.fm レギュラーの西川善二さんが詳しく解説しています。面白かったのでぜひ読んでみてください。
Ollama での Model の見方
パラメーター数と量子化について簡単に理解したところで、 Ollama における Model の見方について説明します。 Ollama の公式ページで Model 一覧を見ると、1つの Model でも色々バリエーションがあると思います。例えば llama 3.1 の場合、下記のように沢山の種類があります。

この Tag名の - で繋がれている部分が何を示しているのかを、8b-instruct-q5_K_M を例に説明していきます。
1. 8b(モデルのパラメータ数)
最初の 8b は、「8b」= 8 Billion(80億) パラメータのモデルを意味します。
例
7b= 7B(70億パラメータ)13b= 13B(130億パラメータ)30b= 30B(300億パラメータ)
2. instruct(モデルのタイプ)
「instruct」= 指示(Instruction) に特化したチューニングがされたモデルです。
LLM(大規模言語モデル)は本来、「与えられた文章の続きを予測するだけのモデル」です。
例:
入力: "The capital of France is"
出力: "Paris"
したがって、そのままでは人間の質問や指示に正しく応答できません。
そこで、人間の指示(Instruction)に適切に応答できるようにチューニングされたのが、 Instruct モデルです。
Local LLM で ChatGPT のように何かを質問したり、指示をして何かをやってもらおうと考えている場合は、 instruction モデルを使う必要があります。
試しにファインチューニングされていないモデルで使ってみると面白いです。何かを質問すると最初は回答っぽい文章を生成するのですが、そこから連想ゲームのように延々と違う方向へテキストを生成し続けます。これをみると、確かに与えられた文章の続きを予測しているんだなということがわかります。
【余談】
Instruction のファインチューニングの話は、 Misreading Chat という Podcast の #115 で色々解説されていたのが、とても面白かったのでぜひそちらを聞いてみてください。
3. q5_K_M(量子化方式)
この部分は、モデルの 量子化(Quantization) を示す部分です。
以下の3つの要素に分けて説明します。
(1) q5(量子化ビット数)
「q5」= 5-bit 量子化(Q5 = 5ビットの整数表現を使用)
(2) K(量子化手法のバージョン)
「K」= k-quant(最新の量子化手法)
q4 や q5 では、 q4_0 や q4_1 という量子化方式も提供されていることが多いですが、k-quant よりも性能劣化が大きいので、基本的には k-quant を選ぶようにするといいようです。
(3) M(量子化の精度レベル)
「M」= Medium(中間の精度バランスをとった量子化)
Mの意味:S(Small) = さらにメモリ効率重視(ただし精度が下がる)M(Medium) = 精度とメモリのバランスが良い(推奨)L(Large) = 精度を重視し、メモリ削減効果は少し低い
利用するGPUにあった Model を選定する
ここまでの知識があれば、どのモデルを使えばいいかが大体わかると思います。
簡単に自分の GPU にあった Model の選び方について説明していきます。
まずはお使いの GPU の確認
モデルのパラメーター数の選択
- 大きいパラメーター数のモデルは通常、より高精度な推論が可能ですが、その分 VRAM 使用量が増えます。
- 例:7B(70億パラメータ)や 13B(130億パラメータ)など、GPU の VRAM に合わせて選びます。
- 大きいパラメーター数のモデルは通常、より高精度な推論が可能ですが、その分 VRAM 使用量が増えます。
量子化方式の検討
- ビット数が大きいほど精度は高くなりますが、その分 VRAM 使用量も増加します。
- 例:Q8 (8-bit) → 精度高め、必要VRAM多め
- Q5 (5-bit) → 中程度の精度とメモリ節約のバランス
- Q4 (4-bit) → 最も軽量、精度低下のリスクが大きい
- ビット数が大きいほど精度は高くなりますが、その分 VRAM 使用量も増加します。
量子化の精度レベル(S, M, L)の選択
- 同じビット数の量子化方式でも、S (Small)、M (Medium)、L (Large) という精度レベルの選択肢があります。
- S:メモリ使用量を最小限に抑えるが、精度の低下が大きい
- M:精度とメモリ効率のバランスが良い
- L:より高精度だが、VRAM 使用量が増える
最終的な判断
ぼくの場合、GTX 1660 Super を利用しており、VRAM は 6GB です。今のところは LLM の推論以外の用途では利用していないため、 GPU の全リソースを LLM 費やして精度を優先したいです。
Ollama の公式ページには LLaMA 3.1 が 8b, 70b, 405b が用意してあります。70b, 405b は量子化したとしても VRAM に乗り切らないため 8b の Model をみます。
用途は ChatGPT のように AI と対話したいため、instruct のファインチューニングされたモデルをみます。量子化ビット数が大きいものからみていくと、 8b-instruct-q5_K_M が 5.7GB なのでギリギリ VRAM に乗り気そうです。
Model が決まれば、下記のコマンドで pull すればそのモデルを利用することが可能です。
ollama pull llama3.1:8b-instruct-q5_K_M
まとめ
今回は、最近 Local LLM で遊んでいくなかで身についた知識や必要だった知識を整理してみました。 最初は闇雲に色々な Model を試していたので、なかなか思ったような精度がでずに悩んでいました。しかし、ある程度知識をつければ最適な Model を見つけて、 Local LLM でも結構実用的に活用することができます。 僕みたいに Local LLM を試したいけど、何の Model を使ったらいいのかよく分からないという方のショートカットになれば幸いです。
